

NVIDIA AIBOX + TensorRT:打造高性能实时语义分割应用
使用TensorRT打造实时语义分割应用
为什么要在端侧做语义分割
语义分割(Semantic Segmentation)在图像分类的基础上更进一步:分类网络回答的是"这张图里有什么",分割网络回答的是"每个像素属于什么"。这种像素级的稠密输出,是很多端侧场景的前提条件:
| 场景 | 分割结果怎么用 |
|---|---|
| 机器人 / 无人车环境感知 | 区分可通行区域(道路、草地)与障碍物,直接供导航栈消费 |
| 自动驾驶辅助 | 车道线、行人、车辆的逐像素标注,支撑规划与控制 |
| 园区 / 工地安防 | 人体区域与背景分离,减少移动侦测误报 |
| 工业视觉 | 缺陷区域、物料区域的面积与轮廓测量 |
把这些计算放在云端做,意味着原始视频流持续上行:一路 1080p 相机的码率轻松到 4~8 Mbps,多路部署时带宽成本和延迟都不可控;更重要的是很多现场根本没有稳定外网。把推理收敛到 AIBOX 这类边缘盒子之后,网络上行的只有结构化结果(掩膜、区域占比、告警事件),数据量降了几个数量级,而且断网不影响本地感知。
TensorRT 在这里的角色是把这个想法变得可行:语义分割是逐像素输出的稠密任务,算力开销比分类高一个量级,直接用 PyTorch/ONNX Runtime 在边缘 GPU 上跑,帧率往往达不到实时要求。TensorRT 通过图优化和精度量化把同一块 Jetson 的可用帧率拉高数倍到数十倍,使"在 60~160 TOPS 的盒子上做实时光流式分割"成为可交付的工程目标。
NVIDIA 系列 AIBOX
AIBOX-OrinNano 和 AIBOX-OrinNX 均搭载 NVIDIA 原装 Jetson Orin 核心板模组,标配工业级全金属外壳,铝合金结构导热,顶盖外壳侧面采用条幅格栅设计,高效散热,保障在高温运行状态下的运算性能和稳定性,满足各种工业级的应用需求。
| AIBOX-OrinNX | AIBOX-OrinNano | |
|---|---|---|
| 模组 | Jetson Orin NX 16GB | Jetson Orin Nano 8GB |
| AI 性能 | 157 TOPS | 67 TOPS |
| GPU | 搭载 32 个 Tensor Core 的 1024 核 NVIDIA Ampere 架构 GPU | 搭载 32 个 Tensor Core 的 1024 核 NVIDIA Ampere 架构 GPU |
| CPU | 8 核 Arm Cortex - A78 64 位 CPU 2MB L2 + 4MB L3 | 6 核 Arm Cortex A78 64 位 CPU 1.5MB L2 + 4MB L3 |
| DDR | 16GB 128 位 LPDDR5 102.4GB/s | 8GB 128 位 LPDDR5 68 GB/s |
| HDMI | 4K@60Hz | 4K@30Hz |
TensorRT:端侧推理的加速器
NVIDIA 系列 AIBOX 支持深度学习框架 TensorRT。TensorRT 是用于高性能深度学习推理的 SDK 与运行时生态,面向生产部署提供低延迟和高吞吐量,生态包括 TensorRT、TensorRT-LLM、TensorRT 模型优化器和 TensorRT Cloud。
NVIDIA 官方给出的 TensorRT 优势:
- 推理速度提升 36 倍
- 优化推理性能
- 加速各种工作负载
- 使用 Triton 进行部署、运行和扩展
落到工程上,TensorRT 主要做四件事:
| 优化手段 | 说明 | 对分割任务的意义 |
|---|---|---|
| 层与张量融合 | 把 Conv+BN+ReLU 这类链式操作合并为单个 kernel | 减少 kernel launch 次数和中间张量的显存读写 |
| 精度量化 | FP32 → FP16 / INT8,利用 Tensor Core | FP16 几乎无精度损失,INT8 需校准但速度再上一档 |
| Kernel 自动调优 | 构建 engine 时为当前 GPU 架构挑选最优 kernel 实现 | 同一份 ONNX 在 Nano 和 Orin 上各自生成最优 engine |
| Engine 序列化 | 优化结果缓存为 .engine 文件,下次秒级加载 | 首次运行慢(分钟级 build)是正常现象,不是故障 |
语义分割与 SegNet
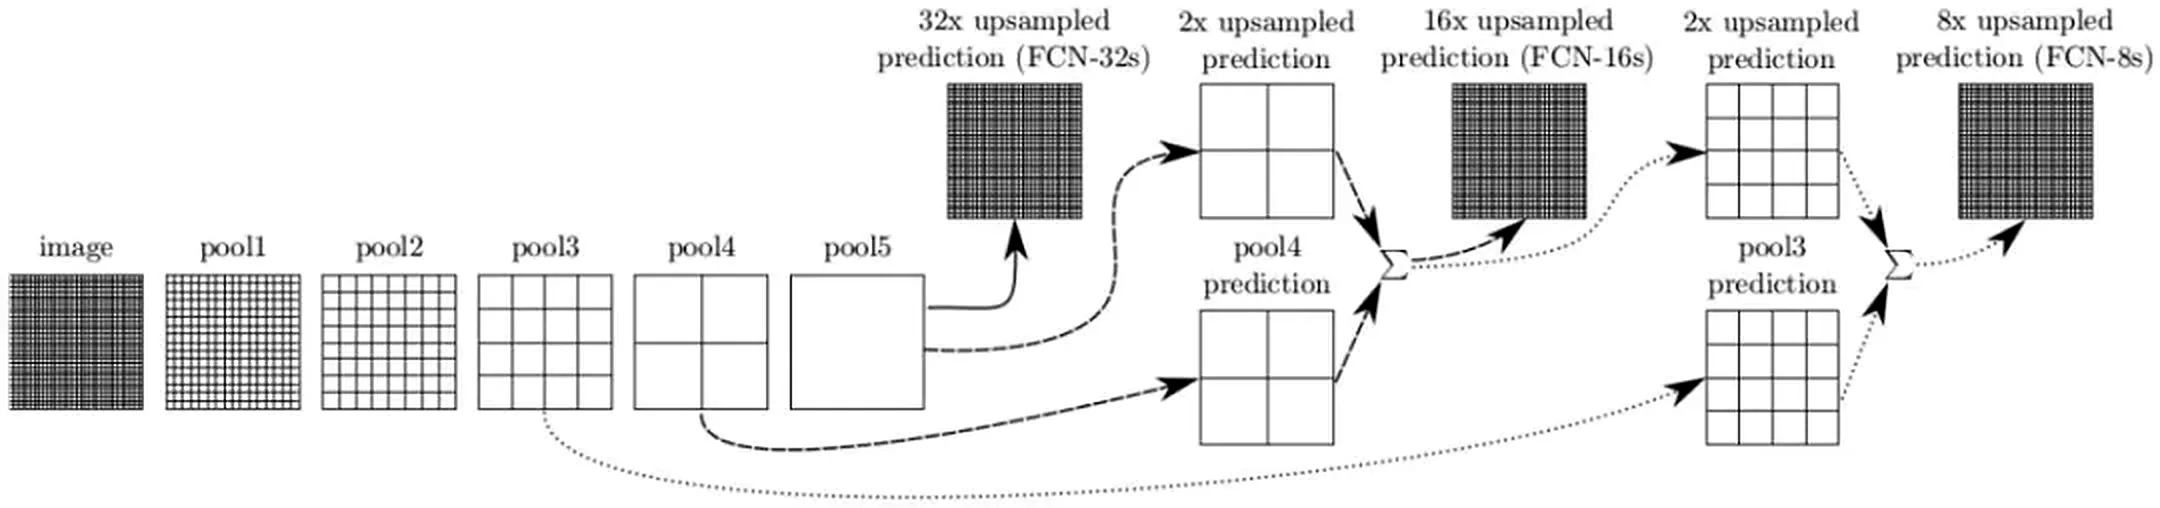
语义分割基于图像识别,但分类是在像素级别进行的,而不是在整个图像上进行。这是通过将预训练的图像识别骨干网络卷积化实现的——把模型转换为能够逐像素标注的全卷积网络(FCN)。语义分割对于环境感知特别有用,它能对场景中的大量潜在对象(包括前景和背景)进行稠密的逐像素分类。
SegNet 模型
SegNet 的新颖之处在于解码器对低分辨率输入特征图的上采样方式:解码器使用对应编码器在最大池化步骤中记录的池化索引执行非线性上采样。上采样后的特征图是稀疏的,随后用可训练卷积核生成稠密特征图。这种"池化索引复用"的设计省去了学习上采样参数的开销,在内存占用和精度之间取得了适合端侧的折中——这也是 SegNet/FCN 类架构在 Jetson 生态里长期作为分割入门标配的原因。
jetson-inference 提供的预训练分割模型
jetson-inference 的 segNet 模块内置一系列 FCN-ResNet18 预训练模型,覆盖街景、人体、室内、野外等常见数据集:
| 数据集 | 输入分辨率 | 网络参数 | 像素精度 | Jetson Nano | Jetson Xavier |
|---|---|---|---|---|---|
| Cityscapes(街景,21 类) | 512x256 | fcn-resnet18-cityscapes-512x256 | 83.3% | 48 FPS | 480 FPS |
| Cityscapes | 1024x512 | fcn-resnet18-cityscapes-1024x512 | 87.3% | 12 FPS | 175 FPS |
| Cityscapes | 2048x1024 | fcn-resnet18-cityscapes-2048x1024 | 89.6% | 3 FPS | 47 FPS |
| DeepScene(野外小径) | 576x320 | fcn-resnet18-deepscene-576x320 | 96.4% | 26 FPS | 360 FPS |
| DeepScene | 864x480 | fcn-resnet18-deepscene-864x480 | 96.9% | 14 FPS | 190 FPS |
| Multi-Human(人体) | 512x320 | fcn-resnet18-mhp-512x320 | 86.5% | 34 FPS | 370 FPS |
| Multi-Human | 640x360 | fcn-resnet18-mhp-640x360 | 87.1% | 23 FPS | 325 FPS |
| Pascal VOC(通用 21 类) | 320x320 | fcn-resnet18-voc-320x320 | 85.9% | 45 FPS | 508 FPS |
| Pascal VOC | 512x320 | fcn-resnet18-voc-512x320 | 88.5% | 34 FPS | 375 FPS |
| SUN RGB-D(室内) | 512x400 | fcn-resnet18-sun-512x400 | 64.3% | 28 FPS | 340 FPS |
| SUN RGB-D | 640x512 | fcn-resnet18-sun-640x512 | 65.1% | 17 FPS | 224 FPS |
部署实操
系统准备
先把功耗模式拉满:
$ sudo nvpmodel -m 0        # MAX-N 满功耗模式(Orin Nano 默认 15W)
$ sudo jetson_clocks        # 锁定 CPU/GPU/EMC 频率到最大值
官方性能表全部基于 MAX-N 测得。默认功耗档下 GPU 频率受限,帧率会打明显折扣。另外建议接上 jtop 或 tegrastats 实时监控:
$ tegrastats # 查看 CPU/GPU 占用、频率、温度、功耗下载源码
$ git clone --recursive --depth=1 https://github.com/dusty-nv/jetson-inference
$ cd jetson-inference
安装依赖与编译
$ sudo apt-get update
$ sudo apt-get install git cmake libpython3-dev python3-numpy
$ mkdir build && cd build
$ cmake ../
$ make -j$(nproc)
$ sudo make install
$ sudo ldconfig参考:https://github.com/dusty-nv/jetson-inference/blob/master/docs/building-repo-2.md
下载模型
$ cd jetson-inference/tools
$ ./download-models.sh
脚本会弹出交互菜单勾选需要的模型。也可以只下分割相关模型(非交互):
$ ./download-models.sh --non-interactive模型文件下载到 jetson-inference/data/networks/ 下,每个模型包含 .onnx 权重与类别标签、颜色表。
运行示例
对单张图片做分割:
$ cd jetson-inference/build/aarch64/bin
$ ./segnet.py --network=fcn-resnet18-cityscapes input.jpg output.jpg
处理完成后查看结果:
$ eog output.jpg输出图是原图与分割掩膜的叠加(overlay),每类对象一种颜色。想看纯掩膜或半透明混合,可以用 --overlay 和 --alpha 参数调整。
接入实时视频流
单张图片只是冒烟测试,实际部署都是流式处理。jetson-inference 用统一的 videoSource/videoOutput 接口抽象了各种输入输出:
# USB 摄像头(/dev/video0)实时分割,输出到 HDMI 显示器
$ ./segnet.py --network=fcn-resnet18-cityscapes /dev/video0

# CSI 摄像头(IMX219/IMX477 等)
$ ./segnet.py --network=fcn-resnet18-cityscapes csi://0

# 处理 RTSP 网络相机,结果通过 RTP 推流出去
$ ./segnet.py --network=fcn-resnet18-cityscapes \
    rtsp://admin:password@192.168.1.100:554/stream1 \
    rtp://192.168.1.50:1234

# 输入视频文件,输出 MP4(离线批处理)
$ ./segnet.py --network=fcn-resnet18-cityscapes input.mp4 output.mp4
配合 --stats 参数可以实时打印每帧耗时(capture / pre-process / network / post-process / render 各阶段分开计时),这是定位 pipeline 瓶颈的第一手数据:
$ ./segnet.py --network=fcn-resnet18-cityscapes --stats /dev/video0